Quando uma aplicação fica lenta, indicadores como CPU, latência média e consumo de banda nem sempre explicam a experiência do usuário. Para investigar a causa, é necessário entender o comportamento real das conversas entre clientes e servidores.
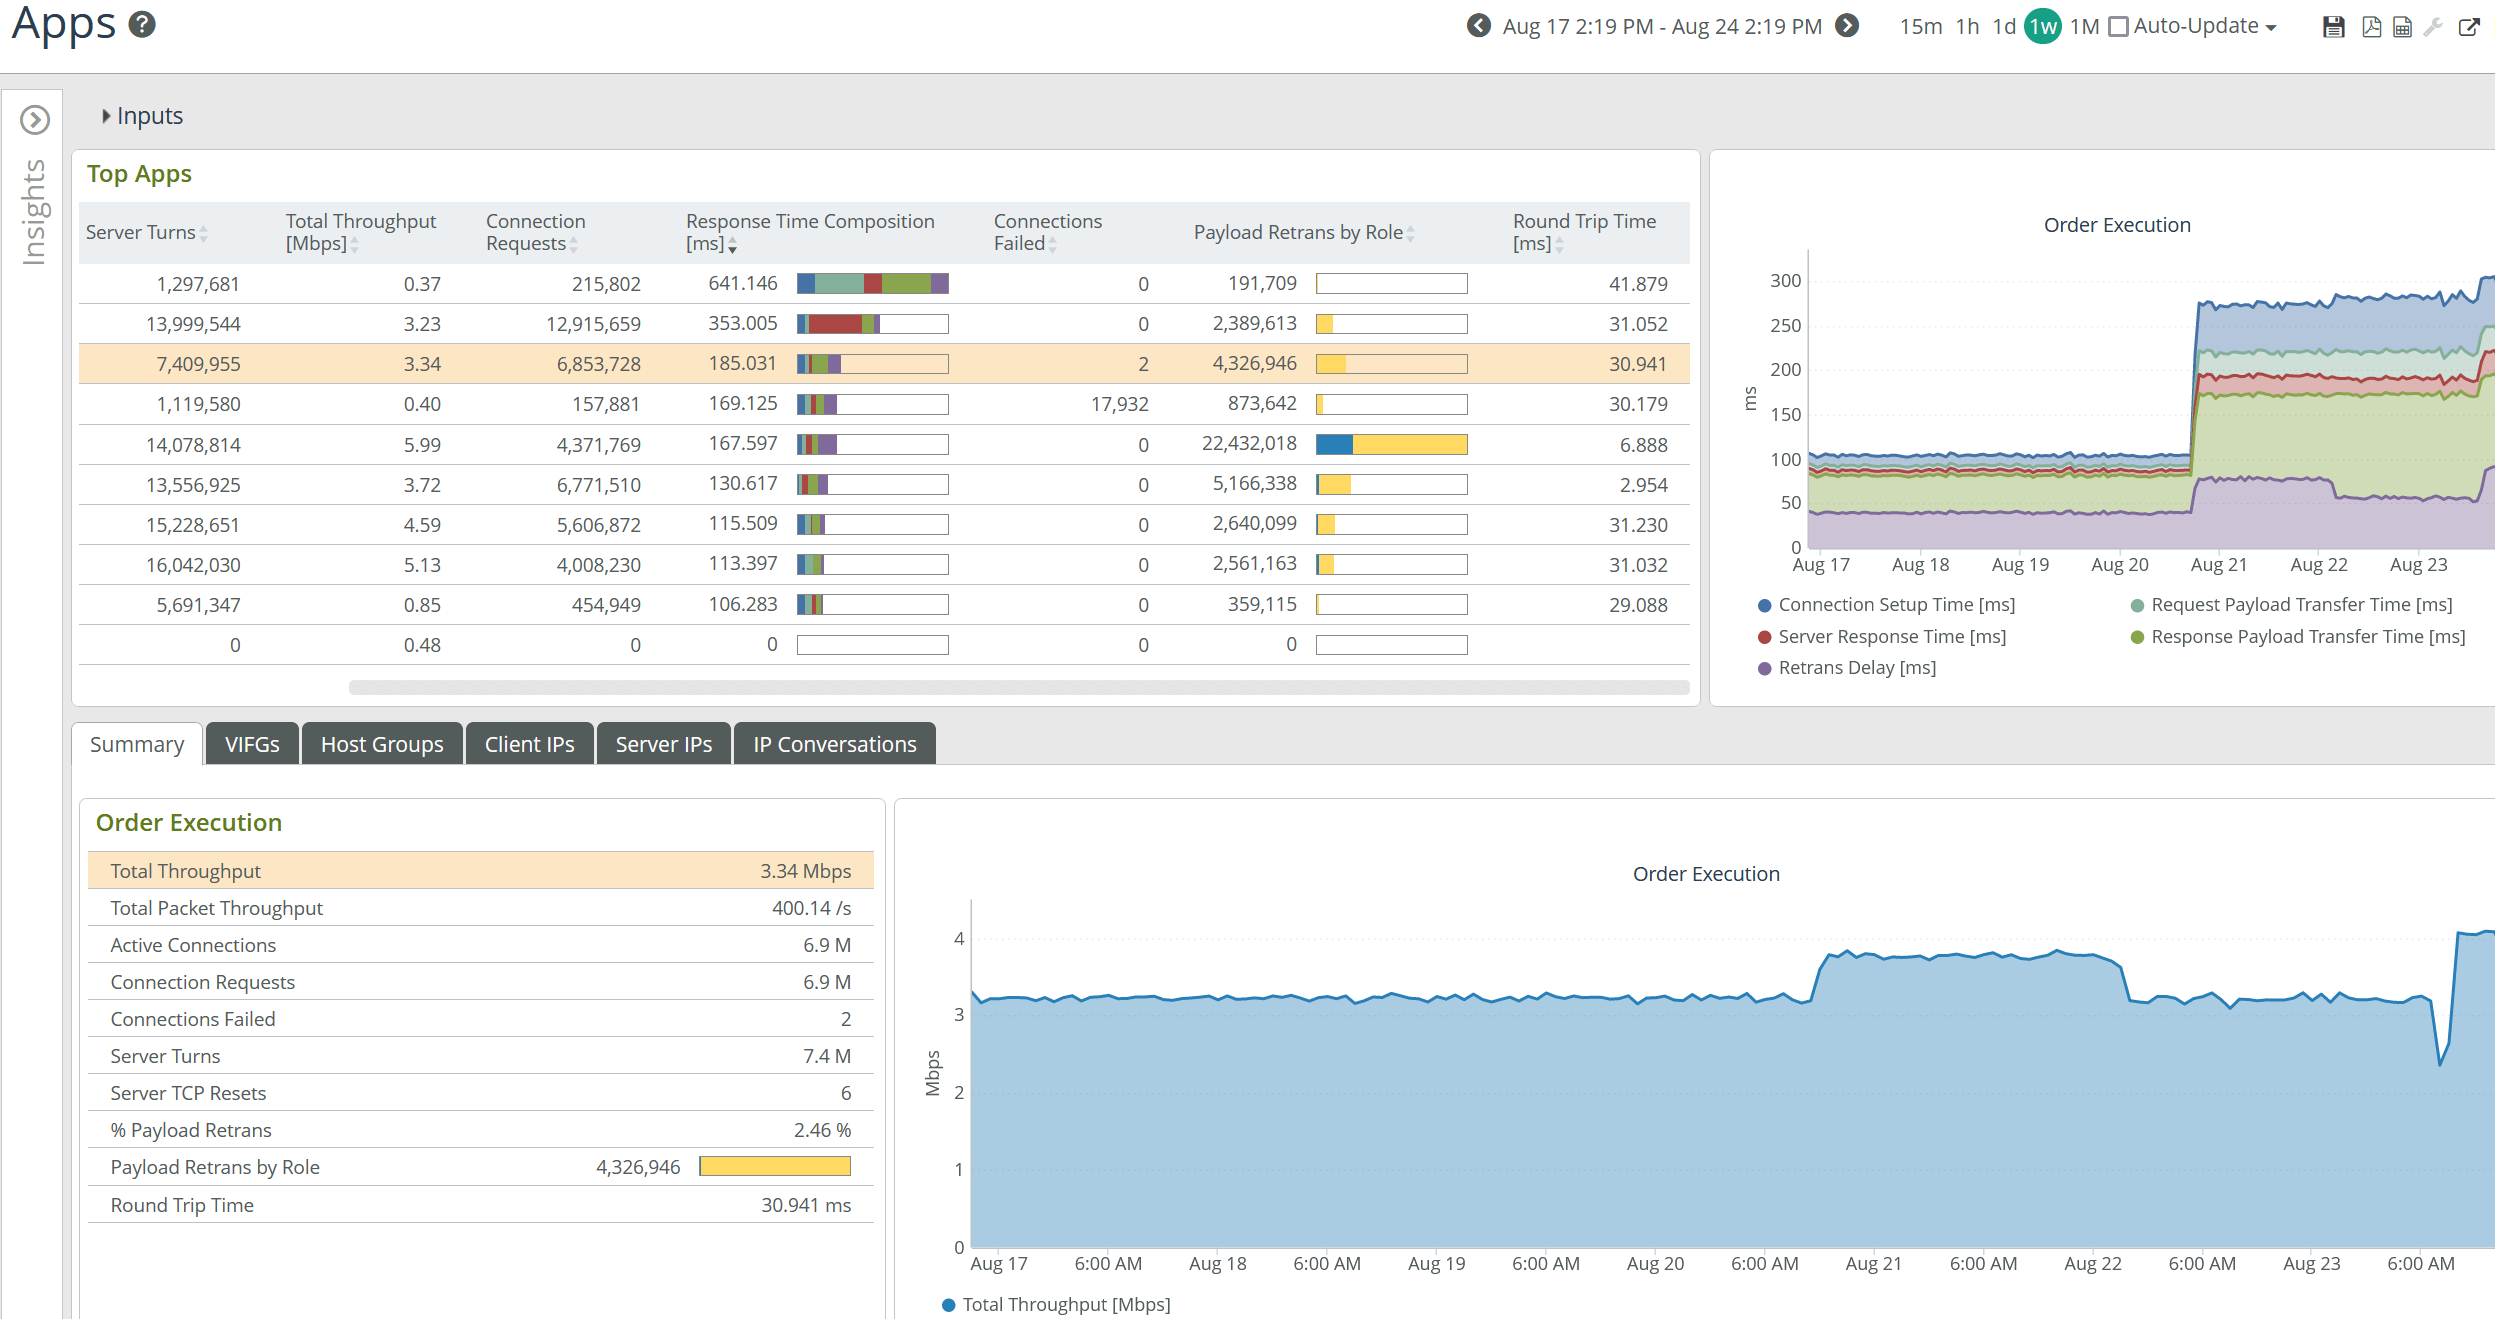
O Riverbed AppResponse ajuda equipes de operações a analisar o tráfego de aplicações e investigar problemas de desempenho com evidências obtidas dos pacotes capturados. Este guia apresenta um método prático para estruturar a investigação e evitar conclusões precipitadas.
Leia também nossa visão geral: Riverbed AppResponse: visibilidade profunda de redes, aplicações e tráfego.
Por que métricas tradicionais nem sempre explicam a lentidão?
SNMP, telemetria de infraestrutura e análise de fluxos ajudam a identificar saturação, erros de interface, tendências de utilização e os principais emissores de tráfego. Porém, esses dados nem sempre mostram o que aconteceu durante uma transação específica.
Um link pode estar longe da saturação e, ainda assim, usuários perceberem lentidão por retransmissões TCP, atrasos na resposta da aplicação, estabelecimento demorado de conexões ou dependências externas. Um servidor com CPU normal também pode demorar para responder a determinadas solicitações.
A análise de pacotes complementa as métricas ao ajudar a reconstruir a sequência temporal da comunicação e localizar em qual etapa surge o atraso. O resultado depende dos pontos de captura, da visibilidade disponível e dos protocolos observáveis.
O que o Riverbed AppResponse acrescenta?
- Tempo de resposta: ajuda a investigar o comportamento temporal das transações conforme o protocolo e os dados disponíveis.
- Análise TCP: auxilia a examinar retransmissões, conexões e sinais de comportamento anormal do transporte.
- Investigação baseada em evidências: aprofunda suspeitas identificadas por métricas, alertas ou relatos dos usuários.
- Correlação operacional: direciona a investigação entre rede, aplicação, servidor e serviços dependentes.
As métricas e funcionalidades disponíveis variam conforme versão, licenciamento, configuração e visibilidade do tráfego.
Como investigar uma aplicação lenta: passo a passo
1. Delimite o incidente
Registre horário, usuários afetados, aplicação, localidades e operações lentas. Verifique se o problema é contínuo ou intermitente e se afeta todos os usuários ou apenas um segmento.
2. Confirme a visibilidade do tráfego
Valide se o ponto de captura observa os sentidos relevantes da comunicação, se o tráfego percorre o caminho monitorado e se os segmentos necessários estão cobertos. Capturas incompletas podem levar a interpretações equivocadas.
3. Examine o tempo de resposta
Compare transações lentas e rápidas e observe os componentes de resposta que a solução consegue identificar. O atraso antes do início da resposta do servidor sugere uma investigação diferente daquela em que a resposta é produzida, mas demora a chegar ao cliente.
4. Investigue retransmissões TCP
Retransmissões podem indicar perda de pacotes ou condições que afetam a comunicação, mas não devem ser interpretadas isoladamente. Verifique frequência, horário, endpoints e correlação com o aumento do tempo de resposta.
5. Correlacione com a aplicação
Compare os horários e endpoints observados com logs, métricas de servidor, banco de dados, balanceadores e outros componentes. O objetivo é restringir o domínio do problema antes de atribuir a causa a uma camada específica.
6. Valide após a correção
Repita a análise nas mesmas condições, quando possível. Compare tempo de resposta, comportamento TCP e experiência dos usuários antes e depois da mudança.
Métricas e sinais que merecem atenção
| Sinal | Possível indicação | Como interpretar |
|---|---|---|
| Estabelecimento de conexão | Atraso ao iniciar a comunicação | Compare endpoints e condições de rede; verifique DNS e etapas anteriores quando aplicável. |
| RTT (Round-Trip Time) | Tempo de ida e volta | Analise tendência e variação; RTT alto não identifica sozinho a causa raiz. |
| Tempo até a resposta | Demora entre solicitação e resposta observável | Correlacione com processamento no servidor e dependências. |
| Retransmissões TCP | Possível perda ou entrega problemática | Observe frequência e correlação com o incidente, considerando a qualidade da captura. |
| Transferência de dados | Tempo para transportar a resposta | Considere tamanho da resposta, janela TCP, throughput e condições do caminho. |
Exemplo prático: lentidão sem saturação do link
Imagine que usuários relatem lentidão enquanto o monitoramento mostra utilização moderada do link e CPU do servidor dentro do padrão. Isso não descarta a rede, mas também não prova que ela seja a causa.
- Delimite o horário e identifique clientes e servidores envolvidos.
- Confirme que o AppResponse observa o tráfego relevante.
- Compare transações lentas e normais, procurando diferenças em conexão, resposta e transporte.
- Correlacione os horários com logs e métricas do servidor e de serviços dependentes.
- Após a correção, repita a análise para validar o resultado.
Monitoramento de infraestrutura, flow e análise de pacotes
| Abordagem | Principal contribuição | Limite típico |
|---|---|---|
| Métricas de infraestrutura | Saúde, capacidade, utilização e erros | Nem sempre explica uma transação individual. |
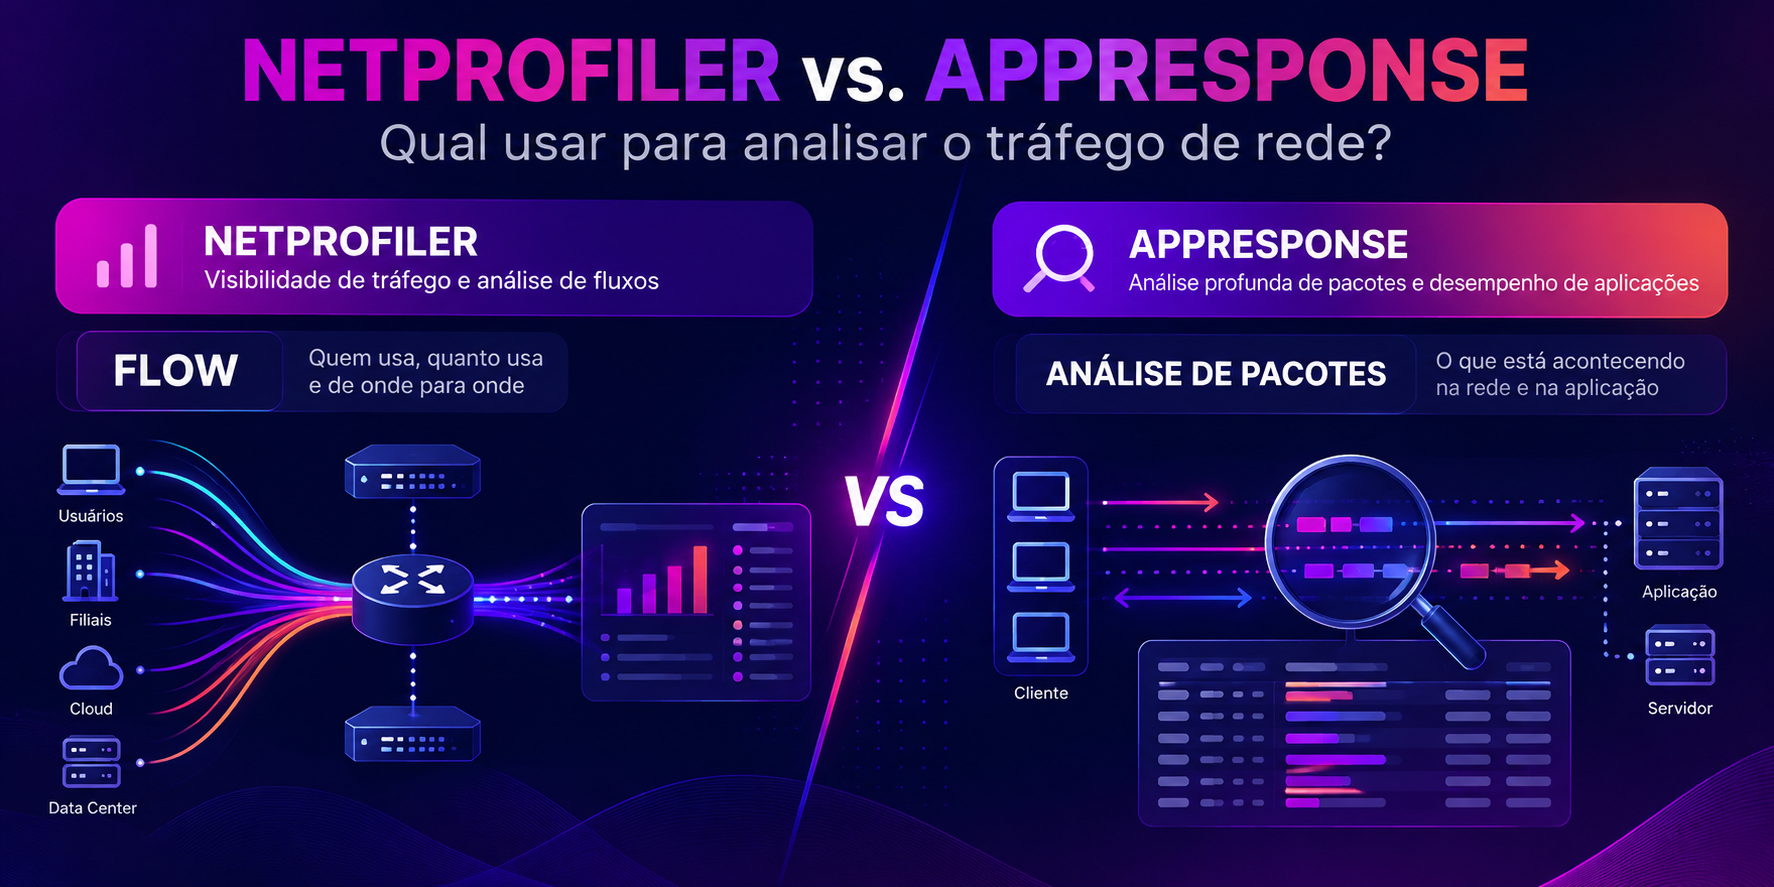
| Análise de flow | Origem, destino, volume e padrões de tráfego | Menos detalhe temporal e de protocolo que uma captura de pacotes. |
| Análise de pacotes | Detalhes observáveis da comunicação | Exige pontos de captura adequados, armazenamento planejado e atenção à privacidade. |
As três abordagens são complementares: ajudam, respectivamente, a identificar problemas de infraestrutura, entender padrões de tráfego e investigar comunicações em detalhe.
Pontos importantes antes de implementar
- Pontos de captura: valide se os caminhos relevantes estão cobertos.
- Volume e retenção: dimensione armazenamento e processamento de acordo com tráfego e necessidade histórica.
- Criptografia: HTTPS limita a leitura do conteúdo. Metadados e indicadores observáveis podem continuar úteis, mas a visibilidade depende do protocolo, da configuração e dos recursos disponíveis. Não presuma acesso irrestrito ao conteúdo criptografado.
- Privacidade: restrinja acesso e alinhe a captura às políticas internas e às obrigações legais aplicáveis.
- Integração: combine achados com alertas, logs e métricas de outras ferramentas.
Perguntas frequentes sobre Riverbed AppResponse
O AppResponse substitui o monitoramento SNMP?
Não. O monitoramento de infraestrutura e a análise de pacotes são complementares. SNMP acompanha indicadores de dispositivos; a análise de tráfego aprofunda a investigação das comunicações e aplicações.
É possível diferenciar lentidão de rede e lentidão do servidor?
A análise pode ajudar a identificar em que etapa observável surge o atraso. A conclusão depende da captura, do protocolo, dos pontos de observação e da correlação com métricas e logs.
Preciso capturar os dois sentidos do tráfego?
Observar os dois sentidos costuma melhorar a interpretação de solicitações, respostas e comportamento TCP. Os requisitos exatos dependem do caso de uso e da arquitetura.
O AppResponse consegue ver o conteúdo HTTPS?
Não se deve presumir acesso irrestrito ao conteúdo criptografado. A visibilidade depende da configuração e dos recursos disponíveis; metadados e indicadores de desempenho podem continuar úteis.
Por quanto tempo os dados ficam armazenados?
A retenção depende do dimensionamento e da configuração. Defina o período conforme o volume de tráfego, a necessidade de análise histórica e os requisitos de segurança.
Conclusão
Investigar lentidão exige mais do que verificar se um link está saturado ou se um servidor apresenta CPU elevada. Ao combinar métricas de infraestrutura, análise de flow e evidências de pacotes, as equipes podem reduzir hipóteses e direcionar o troubleshooting com maior precisão.
Descubra como melhorar a visibilidade da sua rede e das aplicações
Converse com a DeepMonitor para avaliar seu cenário, identificar os principais desafios de troubleshooting e entender como o Riverbed AppResponse pode ajudar sua equipe.
Continue a investigação com outras soluções Riverbed
A análise de pacotes ganha contexto quando combinada com outras fontes de observabilidade. Conheça também:
- Riverbed AppResponse: visão geral da solução e seus recursos de análise.
- Riverbed NetProfiler: análise de flows, conversações e utilização de rede.
- Riverbed NetIM: métricas e topologia para contextualizar a infraestrutura.
- Riverbed Aternity / DEX: contexto da experiência digital percebida pelos usuários.